受託 / 検知AIモデル
見つけたい対象を、写真と動画から検出するモデルをつくる
路面のひび割れ、標識の劣化、設備の錆など、点検の現場で見つけたい対象は業務によって違います。その対象に合わせた検知モデルを、要件の整理から運用中の見直しまで通して構築します。
写真はイメージです
概要
画像から物を見つける技術そのものは、すでに広く使われています。難しいのは、何をどこまで見つければ業務の役に立つのかを決めることと、その判断に沿った学習データをそろえることです。
たとえば、細いひび割れまで拾うように調整すれば見逃しは減りますが、汚れや影まで拾う誤検知が増えます。どちらをどれだけ許せるかは、検出結果をその後誰がどう確認するかで変わります。この受託では、その線引きを技術の数値ではなく、業務の言葉で決めることから始めます。
最初から大量のデータを用意していただく必要はありません。数百枚程度の写真で小さく試し、手応えを確かめてから範囲を広げます。
サンプル
たとえば、こんな検知モデルをつくれます
どんなモデルがつくれるのかを、開発者が自分の走行映像で作ったモデルで紹介します。高速道路の除雪で使う投雪防止表示板を、車に載せたスマートフォンの映像から見つけるモデルです。
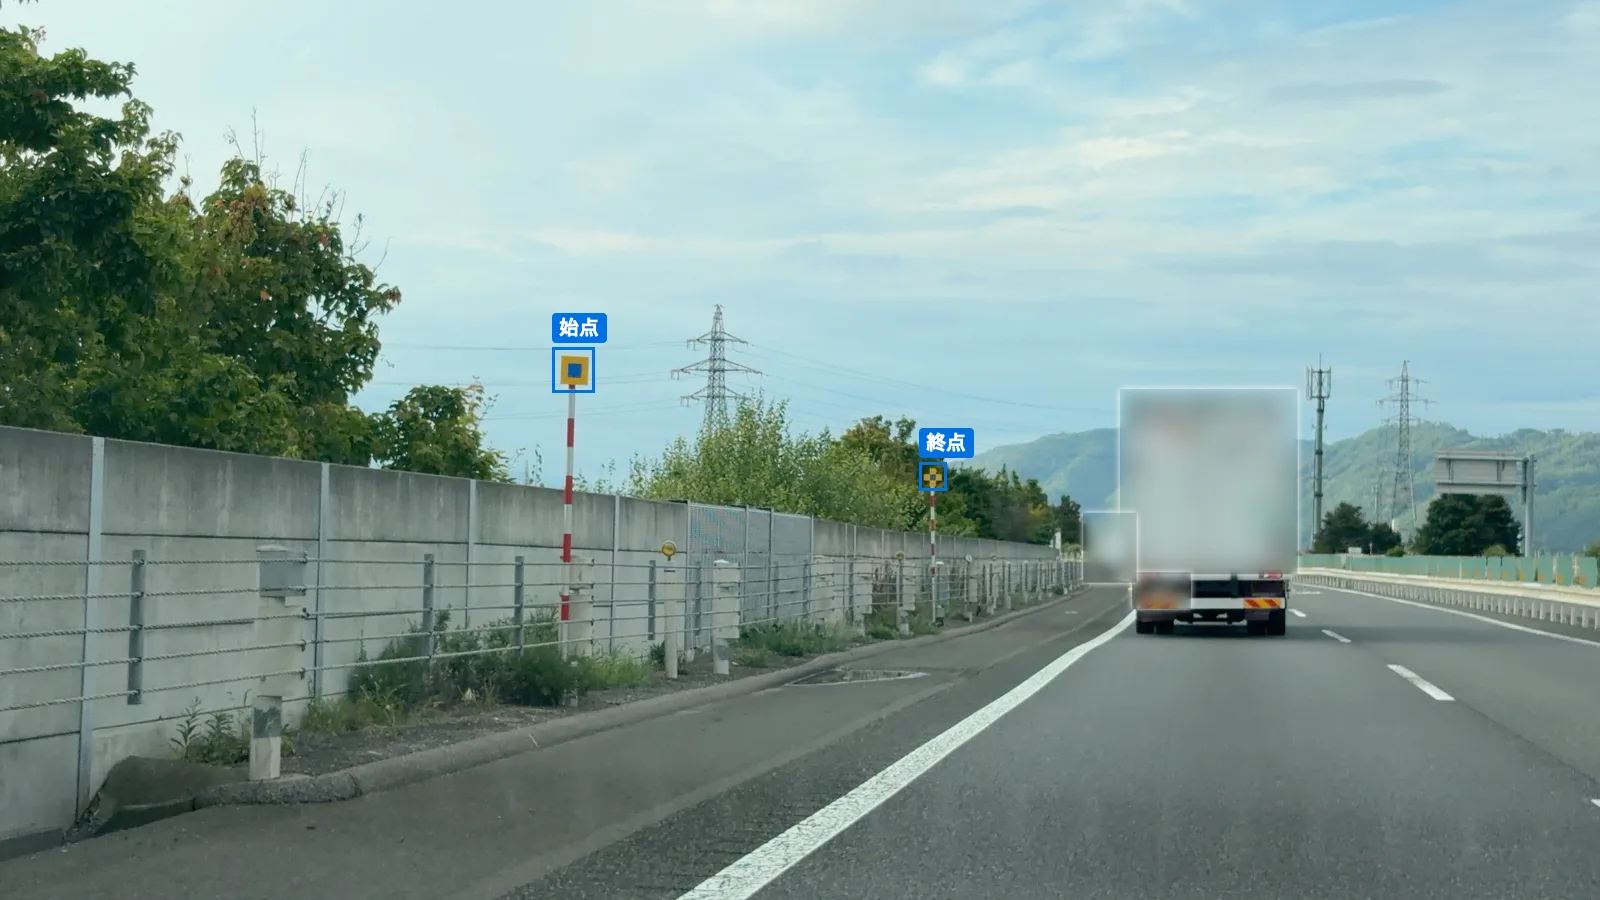
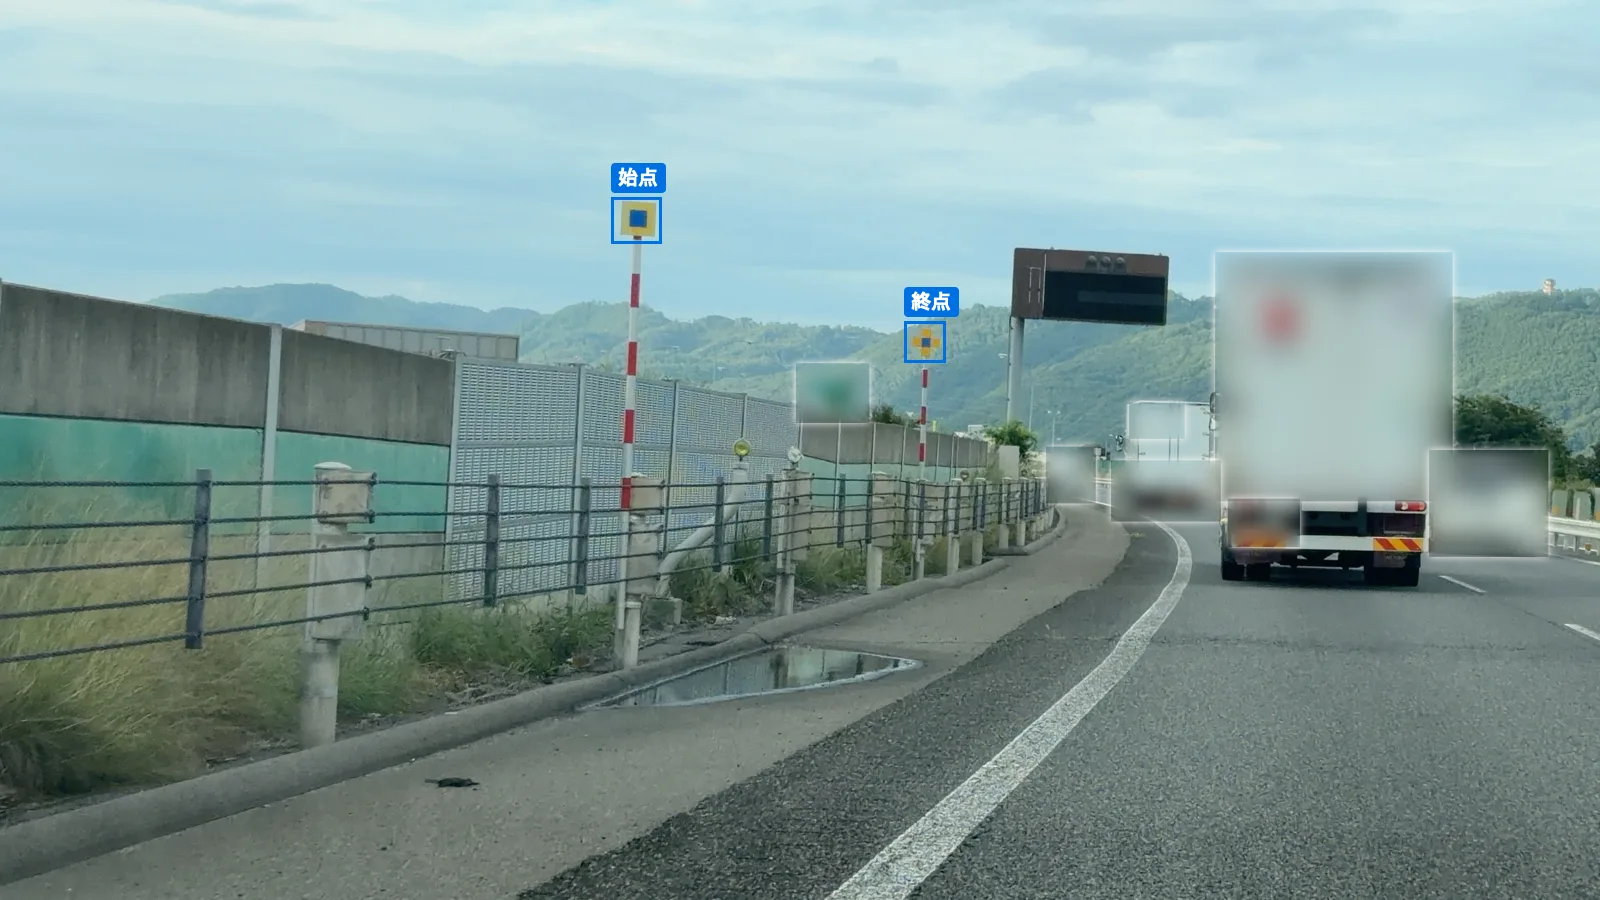
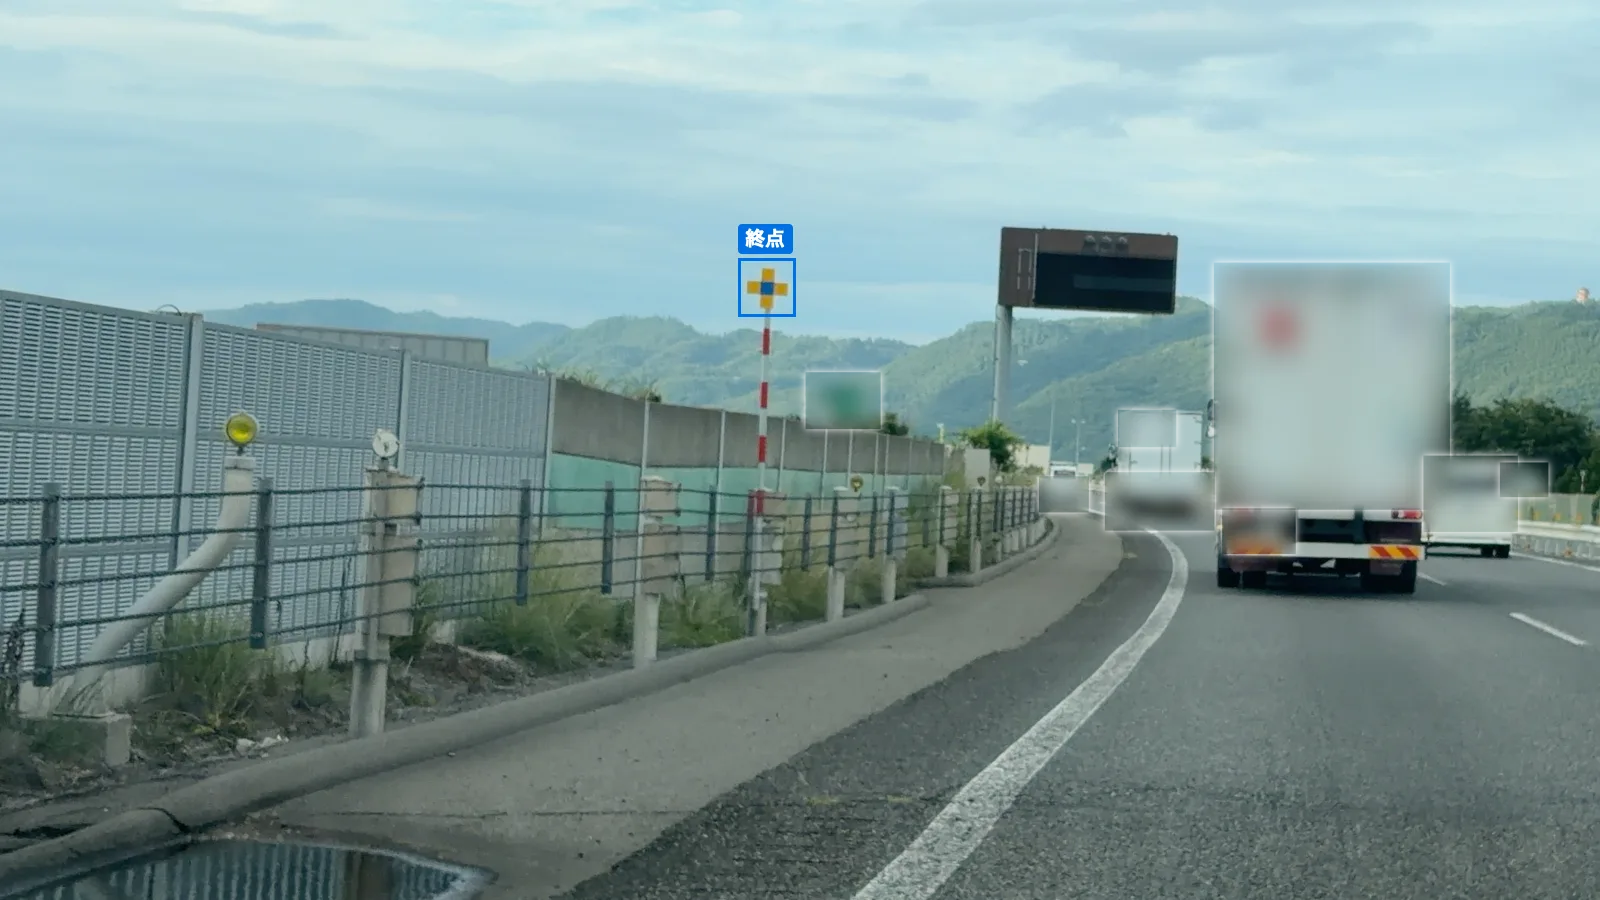
始点と、その先の終点を見つけた例。終点は画面の中で小さく写っています。
学習に使っていない走行映像に、モデルが出した枠をそのまま重ねています。車両の文字・ナンバーと地名の標識はぼかしています。
高速道路の除雪で、雪を投げてはいけない区間の始まりと終わりを見つける
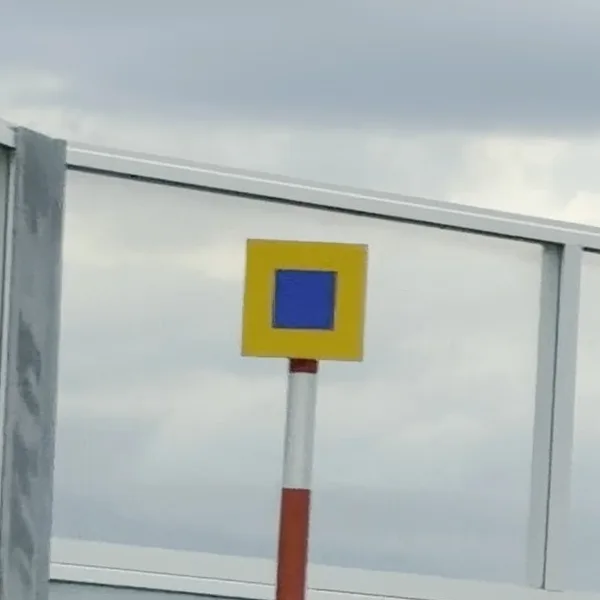
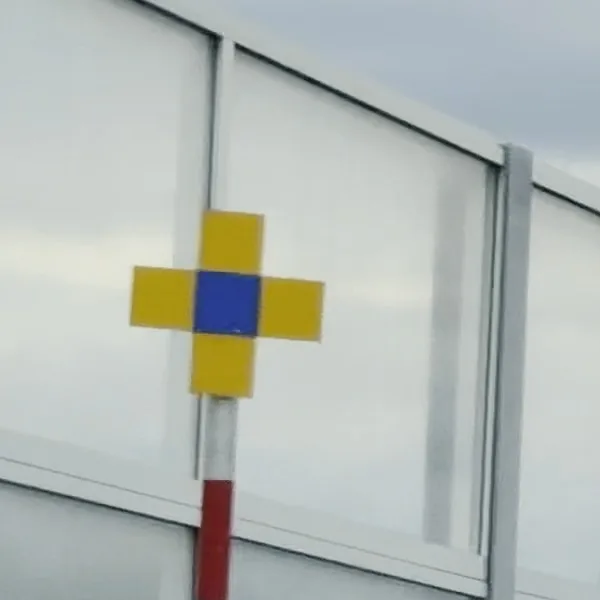
投雪防止表示板は、路肩の下に道路や構造物が交差していて、除雪車が雪を投げてはいけない区間の始点と終点を示す表示板です。これまでは作業する人が目で見て判断していました。
- 見つけるもの
- 投雪防止表示板の始点と終点の2種類。形の違いで見分けます。
- 使う映像
- 車に載せたスマートフォンで撮った、高速道路の前方の映像。
- 見つけたら
- 近づくあいだに何度か見えたら確定し、音で知らせます。見つけた地点と写真は端末に記録し、地図に出します。
動かし方と試験の結果を詳しく見る
- 動かす場所
- スマートフォンの中。遠くの表示板は画面の一部を縮めずに切り出し、近くの表示板は画面全体を縮めて、同じモデルを2回動かします。
- 試験の結果
- 学習に使っていないテスト用の57枚で、始点18個のうち12個、終点21個のうち17個を見つけ、始点と終点の取り違えは0件でした。遠くを見る範囲に写っていた表示板だけを数えています。夜間と雪の時期は、まだ確かめていません。
ほかに相談いただける対象を詳しく見る
標識や付属物の位置を集める
走行映像から標識、照明、カーブミラーなどを見つけ、見つけた地点を記録します。点検する場所の一覧づくりに使えます。
路面の損傷を見つける
ポットホールやひび割れなど、路面の損傷を写真や走行映像から見つけます。道路の穴を見つけるモデルは、モデルラボで公開の準備をしています。
設備の劣化を見つける
点検で撮った写真から、錆や塗装のはがれ、部品の欠けなど、確認したい箇所を見つけて印を付けます。
作業中の目印を見つける
除雪や清掃などの作業中に、決まった目印や区間の境目を見つけて、作業する人に知らせます。
特徴
- 01
線引きを業務の言葉で決める
見逃しを減らすか、誤検知を減らすか。検出結果を人が確認する前提なのか、そのまま集計に使うのかを伺い、評価の基準を一緒に決めます。
- 02
学習データの整備から担当する
写真に正解の印を付けるアノテーションは、モデルの出来を大きく左右します。判断の基準を文書にまとめ、ぶれのないデータをつくります。
- 03
使う場所に合わせて組み込む
スマホ、現場の端末、クラウドのどこで動かすかによって、使えるモデルの大きさが変わります。通信環境や処理の速さも含めて構成を決めます。
進め方
依頼から納品まで
主な成果物
- 01
要件の整理
見つけたい対象、使う場面、検出結果の使い道を伺い、見逃しと誤検知についての考え方を決めます。
- 02
学習データの整備
お預かりした写真や動画を選び、判断基準に沿ってアノテーションを行います。基準は文書にして共有します。
- 03
学習と評価
モデルを学習させ、学習に使っていないデータで評価します。結果は、実際に見逃した例や誤検知した例とあわせて報告します。
- 04
組み込み
スマホ、現場の端末、クラウドなど、使う場所に合わせてモデルを組み込み、動作を確かめます。
- 05
運用と再学習
使い始めると、想定していなかった写真が必ず出てきます。そうした例を集めて再学習し、精度を保ちます。
FAQ
よくある質問
気になる質問を選ぶと、すぐ下に答えが出ます。
Q.01写真は何枚くらい必要ですか。
対象や撮影条件によりますが、まずは数百枚程度から試すことが多いです。試した結果を見て、追加でどのような写真が必要かをお伝えします。
Q.02どのくらいの精度が出ますか。
対象や写真の質によって大きく変わるため、事前にお約束はできません。小さく試した段階で評価結果をお見せし、続けるかどうかを判断していただけるようにしています。
Q.03つくったモデルの権利はどうなりますか。
成果物の権利の扱いは、契約の際に個別に取り決めます。お預かりしたデータを目的外に使うことはありません。
お問い合わせ
まずは状況をお聞かせください
みちカルテの試験運用や検知モデルの構築について、依頼が固まっていない段階でも構いません。手元にある写真や動画の種類と、困っていることを書いていただければ、できることとできないことをお伝えします。